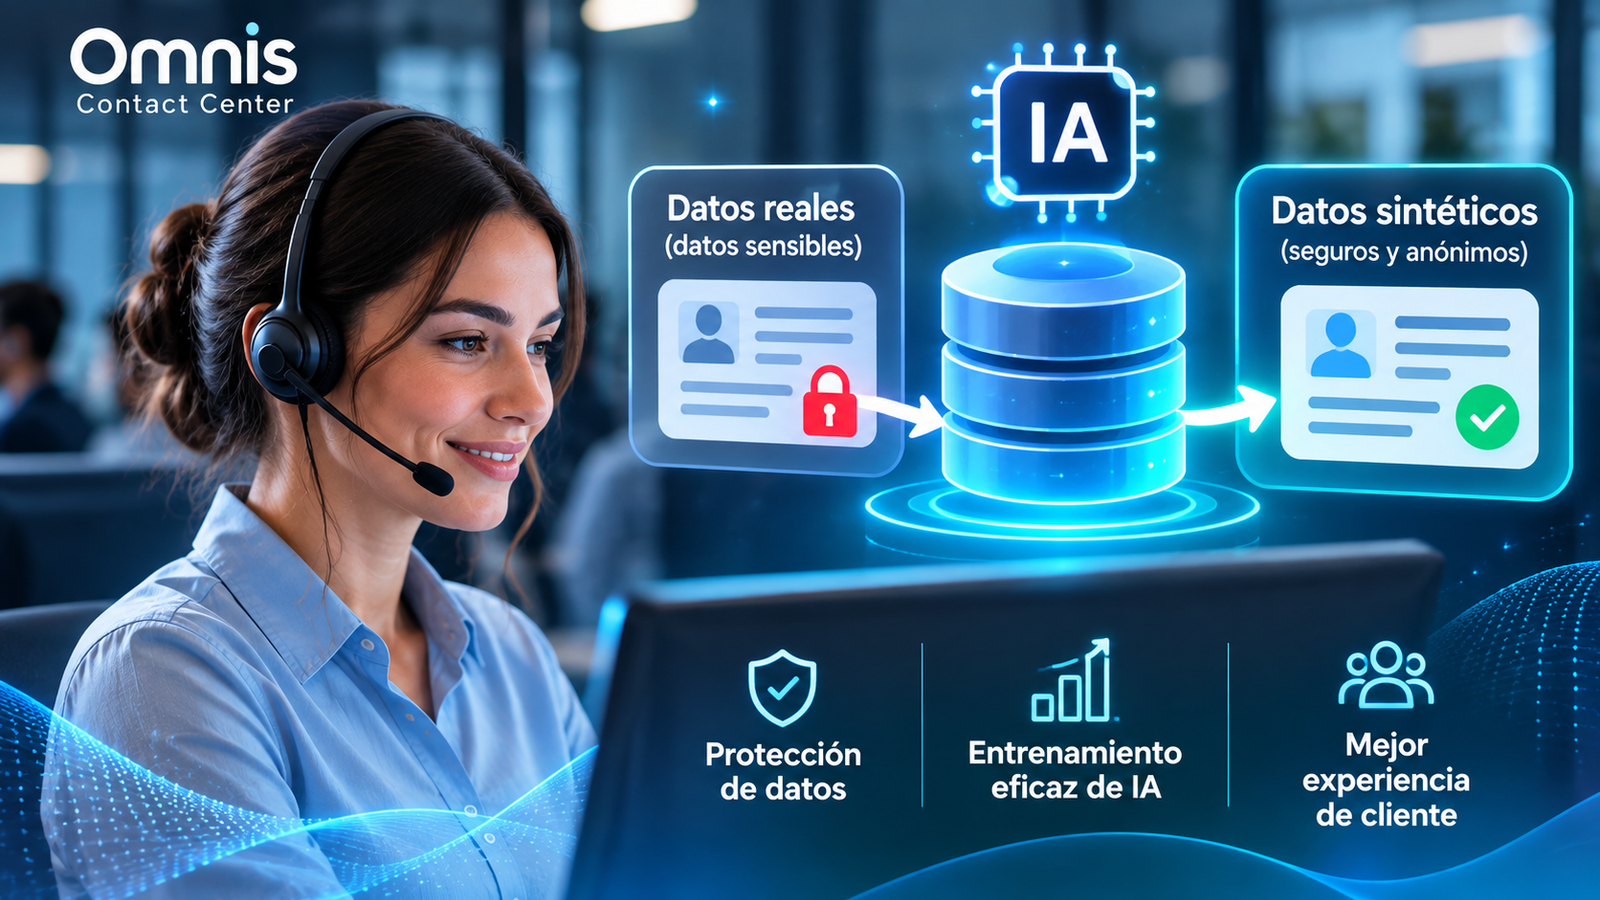
Los datos sintéticos en Contact Center se están convirtiendo en una alternativa estratégica para entrenar, probar y evaluar agentes de inteligencia artificial sin exponer directamente las conversaciones reales de los clientes. Esta práctica permite trabajar con escenarios similares a los del negocio, pero reduciendo la dependencia de información personal, números telefónicos, direcciones, identificadores y otros datos sensibles.
En un Contact Center moderno, la IA necesita aprender a interpretar intenciones, responder preguntas, detectar errores, derivar casos y mantener conversaciones naturales. Sin embargo, utilizar conversaciones reales para cada etapa de desarrollo puede generar riesgos de privacidad, problemas de cumplimiento y restricciones para compartir información con equipos técnicos o proveedores.
Por eso, los datos sintéticos pueden complementar los registros reales y facilitar una estrategia de innovación más segura. No reemplazan por completo la información operativa del negocio, pero ayudan a crear un entorno controlado para desarrollar y validar soluciones de IA conversacional.
¿Qué son los datos sintéticos en Contact Center?
Los datos sintéticos son registros creados artificialmente mediante reglas, modelos estadísticos o sistemas de inteligencia artificial. Buscan reproducir patrones útiles de un conjunto real sin representar necesariamente a una persona específica.
En un Contact Center, pueden tomar la forma de conversaciones simuladas, transcripciones, intenciones de clientes, respuestas de agentes, motivos de contacto, etiquetas de calidad, tonos conversacionales o eventos asociados a una interacción.
Por ejemplo, una empresa puede generar cientos de conversaciones ficticias sobre cambios de dirección, problemas de facturación, cancelaciones, solicitudes de información o reclamos. Esos diálogos pueden incluir variaciones de lenguaje, errores de escritura, interrupciones y distintos niveles de urgencia.
La utilidad está en crear escenarios suficientemente diversos para entrenar y probar un agente IA, sin utilizar de forma directa todos los datos personales presentes en las conversaciones originales.
¿Por qué son importantes para la inteligencia artificial?
Los agentes IA necesitan enfrentarse a múltiples formas de expresar una misma necesidad. Un cliente puede decir que quiere cancelar un servicio, darlo de baja, terminar el contrato o dejar de recibirlo. Si el sistema solo aprende una formulación, tendrá dificultades para comprender el resto.
Los datos sintéticos permiten ampliar la variedad de ejemplos disponibles. También ayudan a representar situaciones poco frecuentes, como consultas complejas, combinaciones de problemas o conversaciones con información incompleta.
Esta capacidad resulta especialmente valiosa cuando una organización tiene pocos registros de ciertos casos. En vez de esperar meses para reunir más interacciones reales, puede crear escenarios controlados y utilizarlos para comprobar cómo responde el sistema.
Además, los datos sintéticos facilitan la colaboración entre las áreas de operaciones, tecnología, experiencia del cliente y seguridad. Los equipos pueden revisar ejemplos representativos sin exponer innecesariamente la identidad de los clientes.
Beneficios de usar datos sintéticos en Contact Center
1. Menor exposición de información personal
El principal beneficio consiste en reducir el uso directo de datos personales durante el desarrollo. Las conversaciones sintéticas pueden evitar nombres reales, teléfonos, correos electrónicos, direcciones, números de contrato y otros identificadores.
Esto no significa que los datos sintéticos sean automáticamente anónimos o libres de riesgo. Si fueron generados a partir de información real, todavía es necesario evaluar si pueden reproducir características que permitan inferir la identidad de una persona. Las autoridades de protección de datos advierten que cuanto más parecidos sean los datos sintéticos a los originales, mayor puede ser su utilidad, pero también el riesgo de revelar información subyacente.
2. Más variedad para entrenar agentes IA
Una base sintética puede incluir distintas edades, formas de hablar, niveles de conocimiento, modismos, errores ortográficos y estilos de comunicación. Esto permite probar si el agente comprende el contexto y no solo palabras clave.
En canales escritos, por ejemplo, es posible simular mensajes breves, reclamos extensos, consultas con emojis o frases ambiguas. En canales de voz, se pueden modelar pausas, reformulaciones y cambios de intención.
3. Creación de casos poco frecuentes
Algunos eventos críticos aparecen pocas veces en los registros, pero requieren una respuesta precisa. Un Contact Center puede generar conversaciones sobre escalamiento de reclamos, intentos de fraude, solicitudes de bloqueo o errores de autenticación.
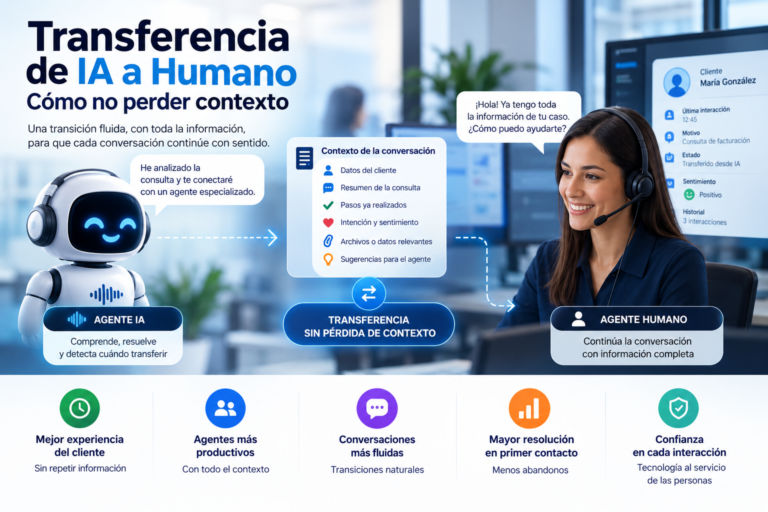
Estos escenarios ayudan a evaluar los límites de un agente IA antes de ponerlo en producción. También permiten comprobar cuándo debe detenerse la automatización y transferir la conversación a un agente humano.
4. Pruebas más rápidas y controladas
Los equipos pueden crear conjuntos de prueba específicos para medir comprensión, exactitud, tono, cumplimiento de políticas y capacidad de derivación. Así, las evaluaciones dejan de depender únicamente de las conversaciones que ocurren de forma natural.
Esto permite ejecutar pruebas repetibles cada vez que se modifica un flujo, una base de conocimiento o una instrucción del agente IA.
Cómo aplicar datos sintéticos en un Contact Center
1. Definir el objetivo de uso
Antes de generar datos, la organización debe determinar para qué los utilizará. El objetivo puede ser entrenar un clasificador de intenciones, probar un voicebot, evaluar un sistema de resumen, simular una campaña outbound o validar una integración con CRM.
Cada objetivo exige diferentes tipos de datos. Para un sistema de enrutamiento se necesitan intenciones y atributos relevantes. Para un asistente de agentes se requieren conversaciones completas, respuestas correctas y criterios de calidad.
2. Diseñar una taxonomía de casos
El siguiente paso consiste en ordenar los motivos de contacto. Una taxonomía clara puede incluir categorías, subcategorías, nivel de urgencia, producto, canal, resultado y necesidad de escalamiento.
Esta estructura ayuda a evitar que los datos sintéticos sean variados, pero poco útiles. La diversidad debe responder a situaciones reales del negocio y no limitarse a generar frases diferentes para la misma intención.
3. Generar conversaciones con reglas de negocio
La IA puede crear diálogos sintéticos, pero debe recibir instrucciones precisas. Las conversaciones deben respetar políticas de devolución, horarios, requisitos de autenticación, condiciones comerciales y límites de actuación.
También conviene incorporar respuestas incorrectas o ambiguas para comprobar si el agente IA sabe pedir aclaraciones, rechazar una acción no autorizada o derivar el caso.
4. Revisar la calidad con expertos
Los datos generados automáticamente necesitan validación humana. Supervisores, agentes experimentados y responsables de calidad pueden verificar si las conversaciones reflejan el lenguaje real de los clientes y si las respuestas propuestas son correctas.
Esta revisión es importante porque un conjunto sintético puede parecer realista y, al mismo tiempo, contener sesgos, situaciones imposibles o políticas desactualizadas.
5. Separar entrenamiento, validación y prueba
No conviene utilizar los mismos ejemplos para todas las etapas. Una parte de los datos puede servir para entrenar el modelo, otra para ajustar sus respuestas y una tercera para medir su desempeño final.
La separación evita resultados engañosos. Si el agente responde bien porque reconoce ejemplos repetidos, la organización puede creer que está listo cuando todavía falla ante variaciones nuevas.
Riesgos y límites de los datos sintéticos
El uso de datos sintéticos no elimina por sí solo los riesgos de privacidad ni garantiza la calidad de una solución de IA. Si el conjunto original contiene sesgos, esos patrones pueden trasladarse a los datos generados.
Por ejemplo, si las conversaciones históricas representan principalmente a un tipo de cliente, el sistema puede aprender a interpretar peor a personas con otros acentos, formas de expresión o niveles de conocimiento digital.
También existe el riesgo de generar datos demasiado artificiales. Una conversación perfectamente ordenada no representa la realidad de un Contact Center, donde aparecen interrupciones, cambios de tema, errores y emociones intensas.
Por esta razón, los datos sintéticos deben combinarse con muestras reales debidamente protegidas. La guía sobre tecnologías de mejora de la privacidad señala que es necesario evaluar la fidelidad, la utilidad, los posibles sesgos y el riesgo de revelar información del conjunto original.
Indicadores para evaluar un conjunto sintético
Un proyecto de datos sintéticos necesita métricas concretas. Algunas de las más útiles son:
- Cobertura de intenciones: porcentaje de motivos de contacto representados.
- Diversidad lingüística: cantidad de formas distintas de expresar una misma necesidad.
- Realismo operativo: nivel de similitud con los flujos y políticas del Contact Center.
- Tasa de duplicación: proporción de ejemplos demasiado parecidos entre sí.
- Riesgo de reidentificación: posibilidad de inferir información de personas reales.
- Equidad: diferencias de desempeño entre grupos, canales o estilos de comunicación.
- Utilidad para el modelo: mejora obtenida en precisión, contención, derivación o calidad.
Estas métricas deben revisarse antes y después de incorporar los datos al entrenamiento. También conviene establecer una fecha de caducidad para los conjuntos que incluyan reglas comerciales o políticas que puedan cambiar.
Datos sintéticos y gobierno de IA
La generación de datos debe integrarse al gobierno general de la inteligencia artificial. Esto implica documentar su origen, objetivo, método de creación, controles aplicados y responsables de aprobación.
Las organizaciones también deben conservar una trazabilidad básica: qué conjunto se utilizó, qué versión del agente lo procesó y qué cambios se realizaron después. Esta información facilita las auditorías y permite investigar errores.
Los marcos regulatorios de IA ponen cada vez más énfasis en la calidad, representatividad, gestión y documentación de los datos utilizados para entrenar, validar y probar sistemas. El artículo 10 del marco europeo de IA, por ejemplo, destaca la necesidad de considerar el origen, la preparación, el etiquetado, la detección de sesgos y la representatividad de los conjuntos de datos.
Cómo puede aprovecharlo un Contact Center con Omnis
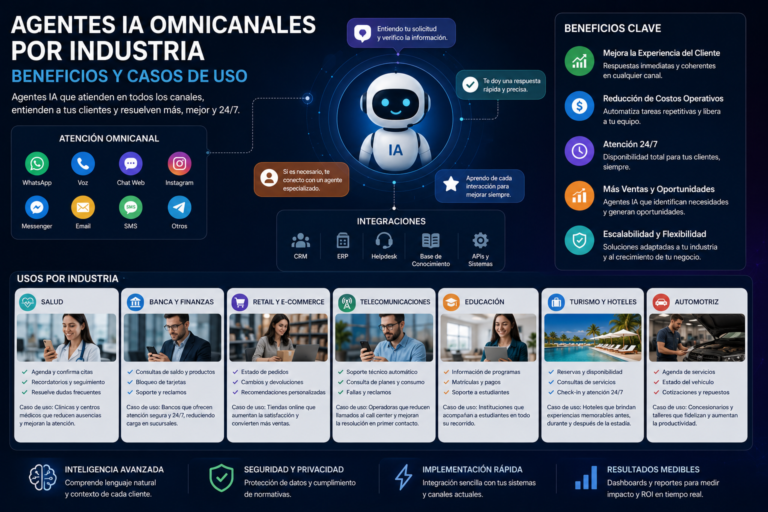
Una estrategia omnicanal puede utilizar datos sintéticos para preparar agentes IA antes de conectarlos con los canales productivos. El equipo puede simular conversaciones de voz, WhatsApp, chat web y correo electrónico, manteniendo criterios de atención coherentes entre todos los puntos de contacto.
También es posible crear escenarios para probar la identificación del cliente, la consulta de información en el CRM, la recuperación de conversaciones y la transferencia a un agente humano con contexto completo.
El objetivo no debe ser automatizar todas las interacciones. Una implementación responsable busca automatizar los casos adecuados y detectar rápidamente cuándo una conversación requiere empatía, criterio o autorización humana.
Conclusión
Los datos sintéticos en Contact Center ofrecen una forma práctica de acelerar el desarrollo de agentes IA, ampliar la cobertura de pruebas y reducir la exposición innecesaria de información personal.
Su éxito depende de utilizarlos con criterio. No basta con generar miles de conversaciones artificiales: hay que definir objetivos, controlar sesgos, validar la calidad, medir el riesgo de reidentificación y combinar los resultados con datos reales protegidos.
Cuando se integran a un modelo de gobierno de IA, los datos sintéticos pueden convertirse en una herramienta clave para innovar con mayor velocidad y responsabilidad. En un Contact Center, esto se traduce en agentes virtuales mejor preparados, pruebas más consistentes y una experiencia de cliente más segura.