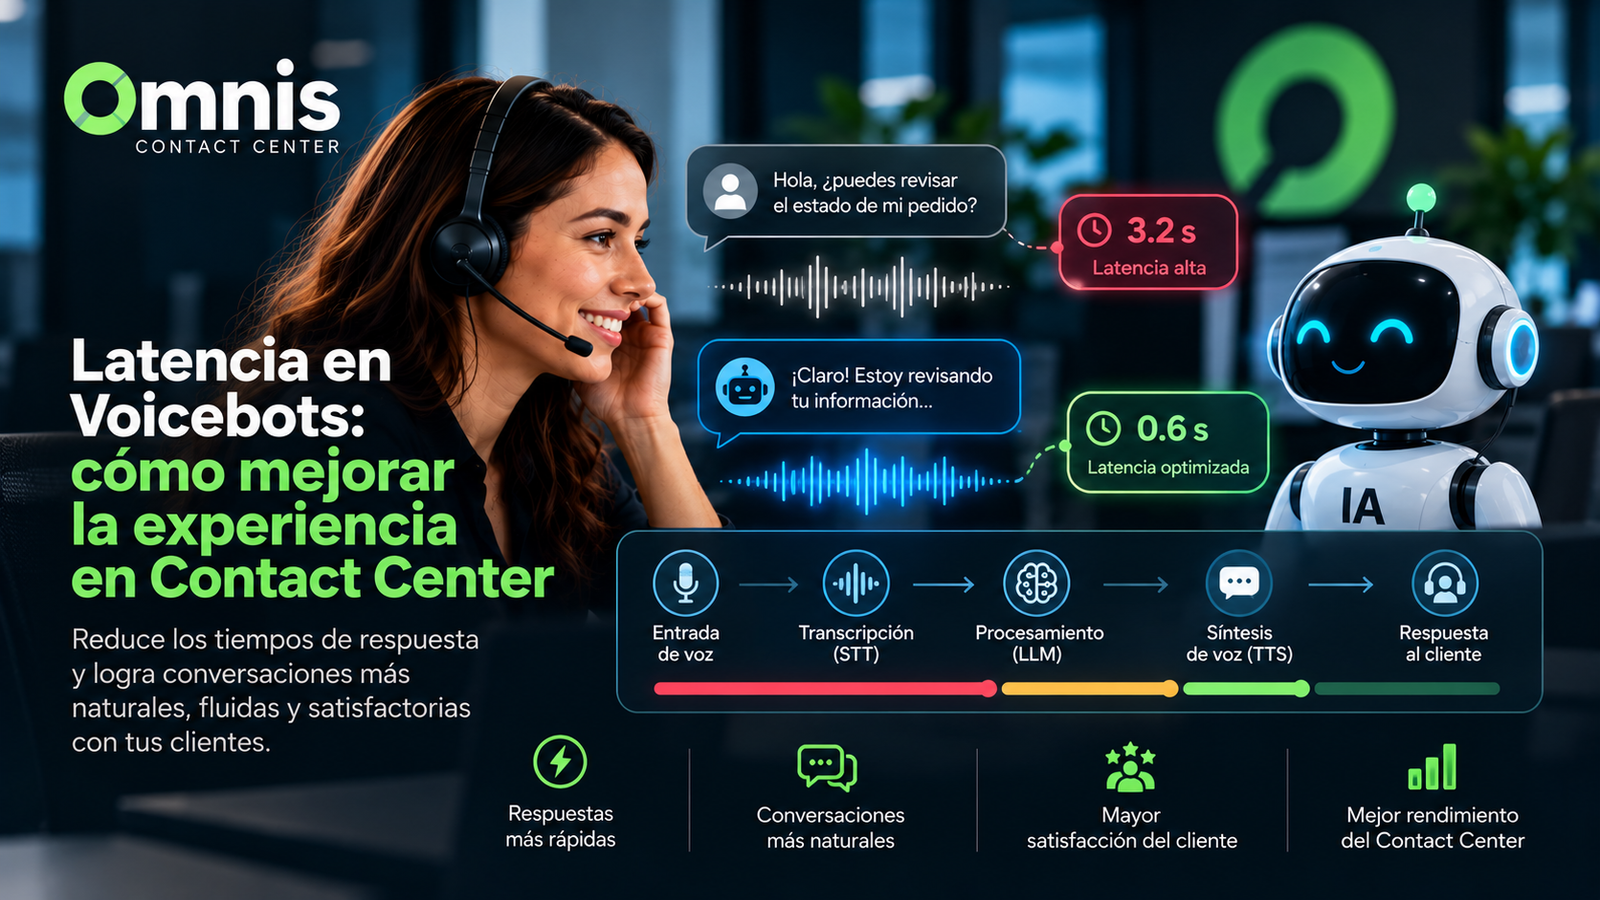
Por qué la latencia en voicebots influye tanto en la experiencia del cliente
La latencia en voicebots es el tiempo que transcurre entre el momento en que una persona termina de hablar y el instante en que el agente de voz comienza a responder. Aunque pueda parecer una demora pequeña, unos pocos segundos de silencio pueden cambiar por completo la percepción de la conversación.
En una llamada telefónica, el cliente no cuenta con elementos visuales que indiquen que el sistema está procesando su solicitud. Por eso, una pausa prolongada puede interpretarse como una falla, una desconexión o falta de comprensión. Cuando la respuesta llega demasiado tarde, la persona puede repetir la pregunta, interrumpir al voicebot o abandonar la llamada.
Reducir la latencia en voicebots no significa únicamente contratar una infraestructura más rápida. También implica revisar el diseño conversacional, la arquitectura de inteligencia artificial, las integraciones con otros sistemas y la manera en que el bot comunica sus tiempos de procesamiento.
Qué componentes generan latencia en un voicebot
La respuesta de un agente de voz con IA no depende de una sola tecnología. Normalmente, la interacción atraviesa varias etapas antes de que el cliente escuche una respuesta.
1. Reconocimiento automático de voz
El sistema primero debe transformar el audio en texto. Este proceso puede demorarse si la persona habla con ruido de fondo, utiliza términos poco frecuentes, cambia de idioma o mantiene una conversación con muchas interrupciones.
Un sistema que espera a que el cliente termine frases demasiado largas antes de procesarlas puede generar una pausa innecesaria. Por eso, los modelos de reconocimiento con procesamiento en streaming ayudan a detectar el contenido mientras la persona todavía está hablando.
2. Comprensión de la intención
Después de convertir la voz en texto, el voicebot debe identificar qué necesita el cliente. La intención puede ser consultar un saldo, modificar una reserva, reportar un problema o solicitar hablar con un agente humano.
Si el sistema envía toda la conversación a un modelo complejo para resolver solicitudes simples, la respuesta puede tardar más de lo necesario. Una arquitectura eficiente combina reglas, flujos predefinidos y modelos de lenguaje según el nivel de dificultad de cada caso.
3. Consulta de información y uso de herramientas
Muchas conversaciones requieren conectarse con un CRM, una plataforma de pagos, un sistema de tickets o una base de datos. Cada llamada a una herramienta externa puede agregar tiempo de espera.
La lentitud suele aumentar cuando las integraciones no están optimizadas, los sistemas se encuentran en regiones geográficas diferentes o el voicebot realiza consultas redundantes. Diseñar APIs específicas para atención permite reducir pasos y devolver únicamente la información que la conversación necesita.
4. Generación y reproducción de la respuesta
Una vez creada la respuesta, el sistema debe convertir el texto en audio. La síntesis de voz también puede generar demoras, especialmente cuando el voicebot produce respuestas extensas o utiliza voces con configuraciones complejas.
El objetivo no es que el agente de voz hable lo más rápido posible. La meta es que pueda comenzar a responder pronto, con una frase breve y útil, mientras continúa procesando los detalles necesarios.
Cómo medir la latencia en voicebots correctamente
Antes de optimizar un voicebot, es necesario medir dónde se produce la demora. Una única métrica general puede ocultar problemas importantes en distintas etapas del flujo.
Algunas métricas recomendadas son:
- Tiempo hasta la primera respuesta: mide cuánto demora el sistema en comenzar a hablar después de que el cliente termina.
- Latencia de reconocimiento: indica cuánto tarda la conversión del audio a texto.
- Latencia de decisión: refleja el tiempo utilizado para interpretar la intención y elegir una acción.
- Latencia de herramientas: mide la duración de las consultas al CRM, APIs o bases de datos.
- Latencia de síntesis: calcula cuánto tarda el sistema en generar el audio.
- Tiempo total de respuesta: representa la demora que realmente experimenta el cliente.
- Tasa de interrupciones: muestra cuántas veces las personas hablan nuevamente porque creen que el sistema no respondió.
También conviene analizar estas métricas por tipo de solicitud, horario, canal, idioma, proveedor de voz y sistema integrado. Un promedio general puede verse bien, aunque ciertos procesos críticos tengan una demora elevada.
Buenas prácticas para reducir la latencia en voicebots
Usar procesamiento en streaming
El procesamiento en streaming permite trabajar con el audio y el texto de forma progresiva. En lugar de esperar a que finalice toda la frase, el sistema puede comenzar a interpretar señales tempranas y preparar una respuesta.
Esta estrategia ayuda especialmente en conversaciones largas. También permite que el voicebot detecte pausas, confirme información y evite esperar más de lo necesario.
Separar solicitudes simples de consultas complejas
No todas las interacciones necesitan un modelo de lenguaje avanzado. Preguntas frecuentes, validaciones básicas y consultas de estado pueden resolverse con flujos rápidos.
La inteligencia artificial generativa debe reservarse para situaciones que realmente requieran comprensión flexible, razonamiento o generación de una respuesta personalizada. Esta clasificación reduce costos y mejora los tiempos de respuesta.
Diseñar respuestas breves y progresivas
Un voicebot no siempre debe esperar a tener toda la información para hablar. Puede iniciar con una confirmación breve, como “Estoy revisando tu solicitud”, siempre que esa frase sea útil y no se utilice para ocultar una integración lenta.
Luego puede completar la respuesta con el resultado. Este enfoque disminuye la sensación de silencio y permite mantener la conversación activa sin saturar al cliente.
Optimizar las integraciones con el CRM
El CRM debe entregar información de manera rápida y estructurada. Para lograrlo, conviene reducir consultas innecesarias, utilizar respuestas en formato liviano, mantener conexiones persistentes y definir tiempos máximos de espera.
Si una consulta excede el límite establecido, el voicebot debe contar con una alternativa. Puede ofrecer continuar por otro canal, solicitar unos datos adicionales o transferir la llamada a un agente con el contexto disponible.
Elegir una infraestructura cercana al público objetivo
La distancia entre el usuario, el proveedor de telefonía, los servicios de IA y las aplicaciones empresariales puede influir en el tiempo total de respuesta. Distribuir los componentes en regiones adecuadas reduce los retrasos de red.
Para operaciones en Chile y otros países de Latinoamérica, es importante revisar dónde se procesan las llamadas y cómo se conectan los servicios utilizados por el Contact Center.
Configurar límites de tiempo y rutas alternativas
Ninguna integración funciona perfectamente todo el tiempo. Por eso, un voicebot debe incluir tiempos de espera máximos, reintentos controlados y rutas de contingencia.
Cuando un servicio externo no responde, es preferible ofrecer una alternativa clara antes que mantener al cliente en silencio. La resiliencia también forma parte de la experiencia conversacional.
El diseño conversacional también puede ocultar o aumentar la demora
La latencia en voicebots no es solamente un problema técnico. Una conversación mal diseñada puede hacer que el sistema parezca más lento, incluso cuando la infraestructura funciona correctamente.
Las frases demasiado largas, las confirmaciones repetitivas y las preguntas ambiguas obligan al cliente a esperar o corregir información. En cambio, los diálogos breves, directos y orientados a una acción reducen la carga cognitiva.
También es recomendable avisar cuando una operación puede demorar unos segundos. Una frase específica, como “Voy a verificar el estado de tu pedido”, genera más confianza que un silencio sin explicación.
Cómo equilibrar velocidad, precisión y seguridad
Reducir tiempos no debe llevar a respuestas apresuradas o incorrectas. Un voicebot que responde rápido, pero entrega datos equivocados, puede aumentar los reclamos y generar nuevas llamadas.
La arquitectura debe equilibrar tres objetivos:
- Velocidad: responder sin pausas innecesarias.
- Precisión: entregar información coherente con los sistemas oficiales.
- Seguridad: proteger los datos del cliente y validar las acciones sensibles.
En operaciones con información financiera, médica o personal, algunas validaciones son indispensables aunque agreguen unos segundos. La clave está en ubicar los controles de seguridad en el momento correcto y evitar verificaciones redundantes.
Qué indicadores conviene monitorear después de optimizar
Una mejora técnica solo es valiosa si produce mejores resultados para el negocio y para los clientes. Por eso, la reducción de la latencia en voicebots debe analizarse junto con indicadores de experiencia y operación.
Algunos indicadores relevantes son:
- Porcentaje de llamadas resueltas por el voicebot.
- Transferencias a agentes humanos.
- Repetición de preguntas durante la conversación.
- Abandono antes de completar el trámite.
- Duración promedio de la llamada.
- Resolución en el primer contacto.
- Satisfacción del cliente después de la interacción.
- Errores en consultas a sistemas externos.
- Porcentaje de respuestas que requieren corrección.
Si la latencia disminuye, pero aumentan las transferencias o los errores, la optimización no fue completa. La velocidad debe acompañar una resolución efectiva y una conversación clara.
Implementar voicebots rápidos dentro de una estrategia omnicanal
Un voicebot no debería funcionar como una herramienta aislada. Para generar una experiencia consistente, debe compartir información con el CRM, los canales digitales, el sistema de tickets y los agentes humanos.
Cuando una llamada se transfiere, el agente debe recibir el motivo de contacto, las respuestas entregadas por el voicebot y las acciones que ya se realizaron. Así, el cliente no necesita comenzar nuevamente su explicación.
Una plataforma de Contact Center CX como Omnis puede centralizar canales, automatizaciones y datos operativos para construir flujos más coordinados. La velocidad de respuesta mejora cuando la tecnología, los procesos y los equipos trabajan con el mismo contexto.
Conclusión: la mejor latencia es la que el cliente casi no percibe
La latencia en voicebots impacta directamente en la naturalidad de una conversación telefónica. Una pausa extensa puede generar frustración, mientras que una respuesta rápida y precisa transmite control y confianza.
Para mejorarla, es necesario medir cada etapa del recorrido: reconocimiento de voz, comprensión, consultas a sistemas, generación de texto y síntesis de audio. También hay que revisar el diseño del diálogo, optimizar las integraciones y preparar rutas alternativas ante fallas.
El resultado esperado no es únicamente un voicebot veloz. Es una experiencia en la que el cliente obtiene respuestas claras, el agente humano recibe contexto y el Contact Center puede resolver más solicitudes sin perder calidad.